


人事データが分散する原因とは? サイロ化の課題と解決策
労務・勤怠・給与・評価・研修・タレントマネジメントなど、人事データが異なるシステムやExcelに分散していませんか。多くの企業が「人事データの活用」の重要性を理解しながら、データの分散(サイロ化)の課題を抱えています。
本当に必要なのは、人事システムを次々と導入することではなく、散在するデータを「正しく一本化」することです。
本記事では、人事データが分散する背景とその弊害、解消方法を紹介し、一元管理を実現するためのステップとツール選定のポイントを解説します。
 目次
目次人事データの分散とは
人事データの分散(サイロ化)とは、人事データが複数の場所に分かれている状態です。各システムごとに情報が分断され、管理者も異なるため、シームレスに業務連携ができません。
| 人事データ | システム | 主な担当者 |
|---|---|---|
| 社員情報 | 労務管理システム/タレントマネジメントシステム | 労務担当/総務担当 |
| 労働時間 | 勤怠管理システム | 勤怠担当 |
| 給与・手当 | 給与計算システム | 給与担当/労務担当 |
| 人事評価・スキル情報 | タレントマネジメントシステム/Excel | 人事担当/各部門の評価者 |
| エンゲージメントスコア | サーベイツール | 人事担当 |
人事データが「ある」と「使える」は違う
人事データが各システムに保存されていても、社員番号・部署名・役職・雇用区分・更新日などがそろっていなければ、すぐに分析や判断には使えません。
結果として、データをまとめる作業に時間がかかり、経営会議の資料作成や人的資本開示、人材配置の検討といった場面で、必要なときに使えなくなります。
人事データが「つながる」メリット
人事データが正しくつながれば、社員一人ひとりのコンディションを正確に把握でき、離職予兆の早期発見や適材適所の配置といった戦略的な人事判断が可能です。
さらに、人事担当者が今までデータ整備に費やしていた時間を、組織開発や戦略的な施策立案といった業務に充てられるようになります。
なぜ人事データは分散(サイロ化)する?主な3つの背景
人事データが分散する背景は、組織の成長過程で、複数の課題に直面した結果として、いくつかの要因が絡み合っています。
個別最適によるシステムの乱立
給与計算は外部の専門サービス、勤怠管理は自社開発システムというように、各部門が「自部門にとって最適な機能」を基準にツールを個別選定した結果、人事システムが乱立しています。
各業務単独では使いやすくても、あとから連携しようとすると、データの加工や既存システムの改修が必要になり、余計なコストや手間が発生します。
部門間の壁
人事部、総務部、現場の各部門が、それぞれ独自の情報管理を進めてきた会社も多くあります。「うちの部門では必要だから」という理由で個別にExcelを整備し、組織全体での情報共有が後回しにされる傾向にありました。
Excel自体が悪いのではなく、更新者・更新タイミング・正となるデータが決まっていないことが問題になります。
データ定義の不一致
人事データは、システムごとに表記や定義が異なる場合があります。同じ部署でも名称の表記が異なっていたり、雇用区分の定義がそろっていなかったりするケースです。
人材の「スキル」についても、資格の保有状況を指す場合もあれば、本人の自己申告や上司の評価を含む場合もあります。さらに、退職者や休職者をデータに残すかどうかが担当者ごとに異なると、システム間でズレが生じます。
その結果、複数のシステムを連携しても情報を正しく照合できず、どの情報を基準にすべきか判断できなくなるのです。
人事データ分散による6つの弊害
人事データが分散している状態は、単なる「管理上の面倒さ」にとどまりません。組織全体の意思決定や人材戦略に影響するデメリットを生み出している場合があります。
データ収集・加工に工数がかかる
人事データ分析を始める前に、複数のシステムからCSVを落とし、Excelで突合し、手作業で整える必要があります。
この作業だけで数日を費やすことになり、分析よりも時間を取られることも少なくありません。
属人化が進むとともに、人事担当者は、戦略的な人材育成や組織改善に時間を使えなくなってしまいます。
情報の鮮度と正確性が低下する
最新情報が一部のシステムにしか反映されず、誤ったデータで判断を下すリスクが生まれます。
「どのシステムのデータが最新か」という混乱が続き、施策の効果測定や評価の納得感が落ちる可能性があります。
また、システムが跨ると、更新漏れや二重登録によるミスが発生しやすくなります。
高度な分析(ピープルアナリティクス)ができない
採用時の適性検査と入社後のパフォーマンスの相関、または勤怠データとエンゲージメント調査の関係性などを見たいとしても、人事データがつながっていなければ分析は難しいです。
結果として、人材の可能性を見落とし、組織全体の生産性向上の機会を逃してしまうかもしれません。
ピープルアナリティクスにおける分析の例
- 部署別の離職率
- 評価と残業時間の関係
- 管理職候補の一覧化
- ハイパフォーマーの共通点
- 研修受講者の配置後の変化
- 最適な配置
タレントマネジメントが進まない
タレントマネジメントに取り組む場合、あらゆる人事データがつながり、使える状態にしておくことは不可欠です。評価、スキル、研修履歴、異動履歴、キャリア希望の人事情報が分かれていると、社員を多面的に見られません。
次世代リーダー候補の選定や後継者計画(サクセッションプラン)を勘や記憶に頼らざるを得なくなります。
結果として、育成投資が本来伸ばすべき人材に届かず、機会損失につながるリスクもあります。
人的資本開示への対応が難しい
人的資本情報の開示に対応するには、採用・配置・育成・評価・離職・エンゲージメントなどのデータを横断して見る必要があります。たとえば、女性管理職比率や教育研修投資額といった指標の可視化が求められています。
人事データが分散していると、投資家から求められる人的資本情報をすぐに出せません。
セキュリティ・ガバナンスの不安が残る
人事データが分散していると、管理の実態が見えにくくなる点もデメリットです。
- 誰がどのデータを更新しているのかわからない
- 退職者の情報が残っている
- 権限設定が古い
人事データには個人情報が多く含まれるため、分散管理は業務効率だけでなく、管理面のリスクにもつながります。
人事データ分散を解消する方法
人事データの分散を解消する方法は、すべてのシステムをすぐに入れ替える方法もあれば、既存システムを活かしながら段階的に整備する方法もあります。
重要なのは、自社の課題が「データの所在がわからない」のか、「更新漏れが多い」のか、「分析に使えない」のかを整理したうえで、適切な方法を選ぶことです。
人事マスタを整備する
最初に取り組みたいのは、人事マスタの整備です。人事マスタとは、従業員に関する基本情報を集約したデータを指します。
人事マスタが整っていないまま情報を連携しても、照合作業は残ります。
そのため、まずは「どの情報を正とするか」「誰が更新するか」「いつ更新するか」を決めます。
CSV連携で定期的にデータを集約する
既存システムをすぐに変えられない場合は、CSV連携で定期的にデータを集約する方法があります。たとえば、月次で勤怠データや評価データを出力し、人事マスタと突合してレポートを作成する運用です。
CSV連携は、導入しやすく、既存システムを活かせる点がメリットです。一方で、ファイル出力、加工、取り込みの作業が残るため、担当者に依存しやすく、ファイル形式の変更や取り込みミスにも注意が必要です。
API連携でシステム間の更新を自動化する
API連携は、システム同士をつなぎ、データの受け渡しを自動化する方法です。
ただし、API連携をすれば、必ずしも、いつでも自動的にデータが整うわけではありません。連携する項目、更新タイミング、エラー時の対応、どのシステムの情報を「正」とし、マスタとして扱うかを決めておく必要があります。
人事システムを統合する
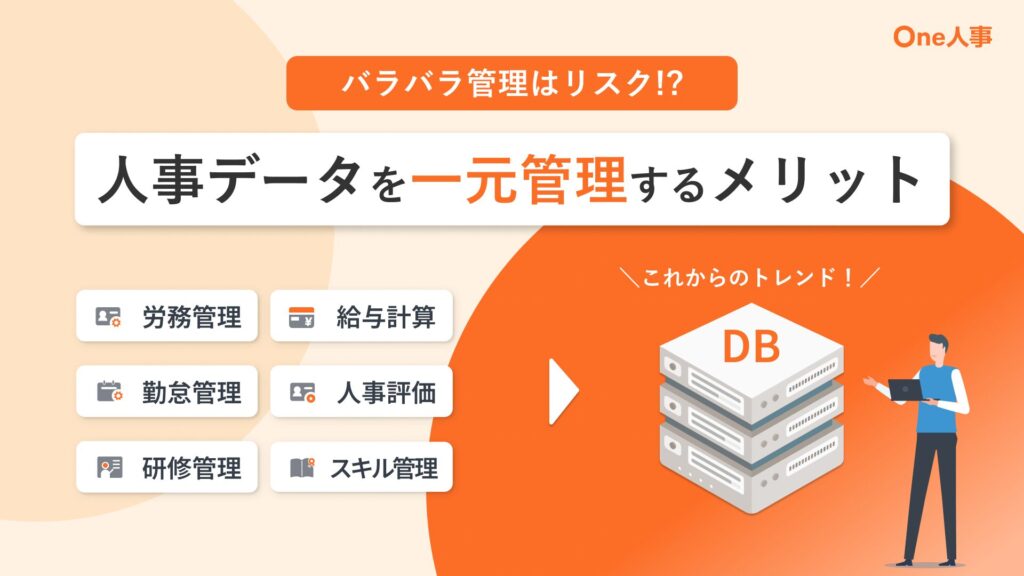
労務、勤怠、給与、評価、タレントマネジメントなどの人事領域を、統合型の人事システムで管理する方法もあります。
人事データを一つのシステム、または共通のデータベース上で管理できれば、複数システムへ個別に反映する手間を減らせます。
人事情報には変化の少ない静的なデータと、タレントマネジメントで必要となる動的なデータの分断を回避するには、統合型人事システムの導入がおすすめです。
統合型の人事システムを選ぶ場合も、一定の構築ステップを踏む必要があります。
BI・データ基盤で可視化する
複数システムのデータを集約し、BIツールやデータ基盤で可視化する方法もあります。
しかし、元データのクレンジングや更新ルールが整っていない場合、可視化しても正しい判断には使えません。
BIやデータ基盤は、分散したデータを見やすくする手段であり、前提として人事マスタやデータ定義の整備が必要です。
人事データを一元管理する5つのメリット
人事データ分散を解消し、一元管理することで、人事部門は単なる管理業務から「戦略的なビジネスパートナー」へと変わります。具体的なメリットを5つ紹介します。
意思決定の迅速化
部署別の人員構成、スキル分布、離職率の推移などを確認し、経営層が組織の状態を把握しやすくなります。
人事データが分散している状態では、資料作成のたびにデータ収集や加工が必要です。
一元管理が進み、リアルタイムなダッシュボードなどが活用できると、経営判断に必要な情報をより一層、早く確認できるようになります。
オペレーションコストの削減
二重登録や手作業での転記、CSVの突合作業を減らし、人事担当者の事務作業を効率化できます。
データ収集や確認に費やしていた時間を、高度な分析や施策企画などの業務に充てやすくなります。
適材適所の人材配置
スキル、経験、評価、研修履歴、異動履歴などの人事データを統合すると、客観的な根拠に基づく異動・配置が可能です。
勘や印象だけでなく、複数の人事データをもとに、社員一人ひとりの状況を把握できる点がメリットです。
本人の意欲や適性を踏まえた配置ができると、従業員のモチベーション向上にもつながります。
離職の予兆検知と対応
勤怠やエンゲージメント調査、面接履歴といった複数のデータを組み合わせることで、離職リスクが高い層を見つけやすくなります。
早い段階で変化に気づければ、面談や配置見直し、業務負荷の調整などの離職対策につなげられます。
評価の納得感向上
評価結果だけでなく、目標達成状況、行動記録、スキル、研修履歴などをあわせて確認できるようになると、評価やフィードバックの根拠を示しやすくなります。
多角的な人事データを活用することで、より公正で透明性の高い人事評価制度の構築が可能です。
人事データ分散を解消し、一元管理を構築する5ステップ
人事データ分散を解消するには、「正」とする人事マスタを決め、一元管理を実現する必要があります。次の5ステップに沿って取り組んでみることをおすすめします。
ステップ1:活用目的の明確化
人事データの分散を解消し、「何のためにデータを統合するのか」を定義することが重要です。
離職防止なのか、次世代リーダーの育成なのか、それとも給与・手当の最適化なのか。目的があいまいなまま進めると、必要なデータと不要なデータの判別ができなくなり、後々の運用が破綻してしまいます。
経営層と人事部の間で、目的をしっかり合意形成することから始めましょう。
ステップ2:現状のデータ棚卸し
各システムで共通して使う基本の人事情報を整理します。
どこに、どのような項目が、どんな形式で人事データが保存されているかを可視化します。
ステップ3:データクレンジングと定義の統一
重複の削除、表記揺れの修正など、マスターデータの共通化を行います。
ここがそろっていないと、勤怠・給与・評価・スキル情報をつなげても、確認や照合作業はなくなりません。
項目ごとのルールを統一し、どのシステムでも同じ定義で人事データを扱えるようにすることが、一元管理の土台となります。
ステップ4:統合方法の選定
データの棚卸しと定義の整理ができたら、自社に合ったマスタの統合方法を選びます。
連携先が少なく、更新が少なければ、CSV連携やAPI連携で十分な場合もあります。また、経営層向けのデータ可視化で十分であれば、BIツール採用も選択肢となります。
一方、保守負担やデータの不整合が課題となっている場合、将来的に分析やAI活用を進める場合は、「One DB型」の統合型人事システムを選択することで、長期的な運用の安定性を確保できる場合が多いです。
今後の人事データの活用方針を踏まえて選定しましょう。
ステップ5:運用ルールの策定と定着
人事データの更新サイクル、閲覧権限、メンテナンス体制を構築します。
導入して終わりではなく、継続的にデータの鮮度を保つための体制づくりが、安定的な運用と定着を左右します。
人事データの一元管理を支えるツール選定のポイント
人事データ分散を解消する方法は複数ありますが、どの方法を選ぶ場合も、確認したいポイントがあります。なかには「高機能だから」「大手企業が使っているから」という理由で選択して失敗する企業もあるため注意したいところです。
既存システムとの連携性
既存の勤怠や給与システムとシームレスにデータ共有ができるか、確認します。
API連携などの場合、連携先の仕様変更による影響、処理停止、データ同期のタイミングずれなど、API特有のリスクも存在することを念頭に置く必要があります。
ユーザビリティ
現場のマネジャーや社員がストレスなく入力・閲覧できるUIか、実際に試用してみることが重要です。操作が複雑すぎるシステムは、結局現場がExcelに回帰してしまい、データが古くなるという悪循環を招きます。
データ可視化機能の充実度
専門知識がなくても、直感的にグラフ化やクロス集計ができるか、また細かい条件設定で多角的な分析ができるかを確認します。
部署別、職種別、年代別に「偏り」を見つけ出す力が、その後の施策を左右するのです。
マスターデータの一意性
社員番号が変わった際や、出向・復職の際に、同一人物としてデータを過去から未来まで一本の線で管理し続けられる構造になっているかは重要です。
「見かけだけの統合」ではなく、一人ひとりの従業員を継続的に追跡できるシステムを選択することが、人事データ活用において求められています。
まとめ:人事データの分散を解消し「攻めの人事」へ
人事データの分散(サイロ化)は、戦略的な意思決定を阻む要因となります。
まずは現状の棚卸しから始め、一元管理に向けた基盤を整えることが、人的資本経営においても大切な最初のステップです。
データドリブンな人事を推進し、組織の競争力を高めていきましょう。地道にデータの正確性を担保し、そろえておくことは、将来的なAI活用を前提とした人事データ分析においても重要です。


